数据处理与存储支持服务 抽取与转换生产、设备及产品数据
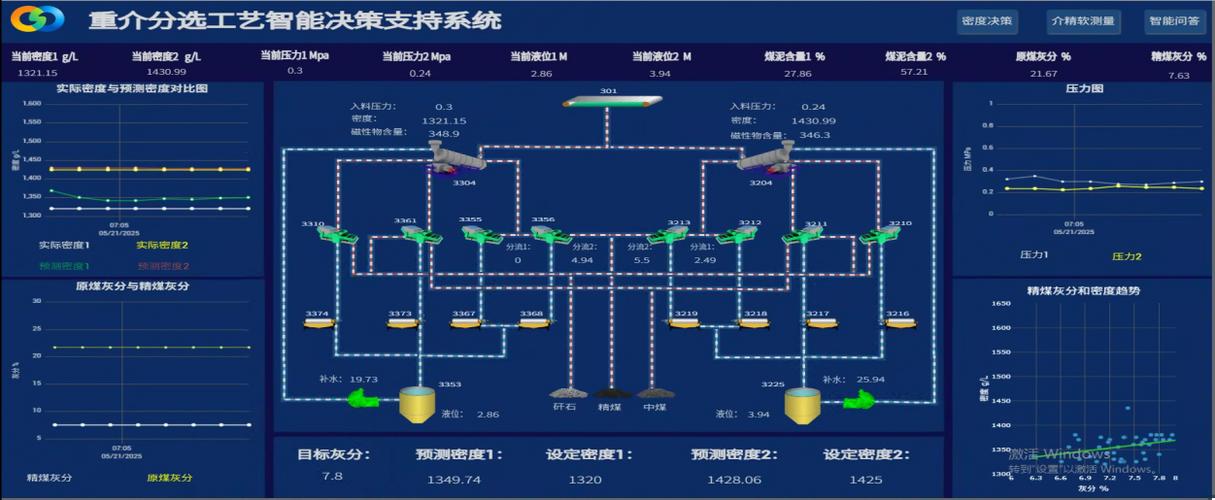
在当今的数字化制造环境中,企业积累了大量的生产数据、设备数据和产品数据。这些数据分散在不同的系统和格式中,如何有效地抽取、转换并实现统一的数据处理和存储,成为提升运营效率和决策质量的关键。本文将探讨针对这些数据的处理与存储支持服务,重点介绍数据抽取、格式转换以及最终的存储方案。
一、数据抽取:从多源异构系统中获取原始数据
生产数据通常来自MES(制造执行系统)、SCADA(数据采集与监控系统)等,设备数据来自PLC、传感器和物联网网关,产品数据则可能来自PLM(产品生命周期管理)、ERP或CRM系统。这些数据源在结构、协议和更新频率上差异显著。
数据抽取服务需要支持多种方式:
- 实时抽取:通过OPC UA、MQTT、Kafka等协议,从设备或消息队列中流式获取数据。
- 批量抽取:通过JDBC、ODBC或API接口,定时从关系型数据库、数据仓库中抽取历史数据。
- 文件抽取:解析CSV、JSON、XML、Excel等文件格式,获取离线数据。
抽取过程中需确保数据的完整性和一致性,同时处理网络中断、数据延迟等异常情况。
二、数据转换:统一格式与语义映射
抽取到的原始数据往往格式各异、单位不统一、编码不同,甚至存在缺失值或异常值。数据转换的目标是将这些数据转化为标准化、可分析的格式。
关键转换步骤包括:
- 格式转换:将不同格式(如JSON、XML、二进制)统一为结构化格式(如Parquet、Avro或关系表)。
- 单位与量纲转换:例如将温度从华氏度转为摄氏度,将产量从“件/小时”转为“件/分钟”。
- 语义映射:将不同系统中的字段名映射到统一的数据模型。例如“设备ID”在不同系统中可能称为“deviceid”、“equipno”或“machine_code”。
- 数据清洗:去除重复记录、填充缺失值、修正异常值,并添加时间戳和来源标识。
转换过程通常借助ETL(抽取、转换、加载)工具或流处理框架(如Apache NiFi、Apache Flink、Spark)来实现,确保高效且可扩展。
三、数据处理和存储支持服务
转换后的数据需要可靠、高效地存储,并支持后续的查询、分析和应用。数据处理和存储支持服务应包括:
- 存储层设计:
- 贴源存储:保留原始数据,用于审计和回溯。
- 标准存储:存储转换后的结构化数据,通常采用数据湖(如HDFS、S3)或数据仓库(如ClickHouse、Snowflake)。
- 主题存储:针对特定业务主题(如设备效率、产品质量)建立数据集市,便于快速访问。
- 数据处理能力:
- 批处理:使用Spark、Hive等处理历史数据,生成报表和指标。
- 流处理:使用Flink、Kafka Streams实时处理设备数据,支持实时监控和预警。
- 数据服务化:通过API网关将处理后的数据以RESTful或GraphQL接口暴露,供上层应用调用。
- 数据治理与安全:
- 元数据管理:记录数据来源、转换规则和血缘关系。
- 数据质量监控:定义质量规则,自动检测异常并告警。
- 安全控制:基于角色的访问控制、数据脱敏和加密传输。
四、实践建议
- 统一数据模型:在转换阶段定义企业级数据模型,避免后期整合困难。
- 采用分层架构:贴源层、标准层、主题层分离,提高灵活性和可维护性。
- 自动化运维:利用调度工具(如Airflow)和监控平台,确保数据管道稳定运行。
- 云原生与混合部署:根据需求选择云服务或本地部署,兼顾成本与合规。
五、
数据处理和存储支持服务是制造企业数字化转型的基础设施。通过高效的抽取、转换和存储,企业能够将分散的生产、设备和产品数据转化为有价值的资产,支撑实时监控、预测性维护、质量分析等高级应用,最终实现降本增效和智能决策。
如若转载,请注明出处:http://www.dvuuvd.com/product/54.html
更新时间:2026-10-09 06:48:05